

Осуществляется ли полнотекстовый поиск по файлам формата PDF?
PDF-файлы могут содержать текст и графические элементы.
Файлы, полученные со сканера, содержат только графический слой (современные сканеры часто сканируют несколько страниц в pdf-файл). Для извлечения текстов таких файлов в «1С:Документооборот» используется программа ImageMagick, которая преобразует PDF-файл в несколько файлов формата .png. Затем при помощи компоненты CuneiForm из этих файлов извлекается текст.
Текст из файлов формата PDF, которые содержат текстовый слой, может быть извлечен с помощью плагина Adobe iFilter.
ImageMagick, CuneiForm и плагины iFilter необходимо самостоятельно установить на компьютер, на котором будет производиться извлечение текстов.
Если тексты извлекаются на сервере необходимо установить компоненту GhostScript на сервере.
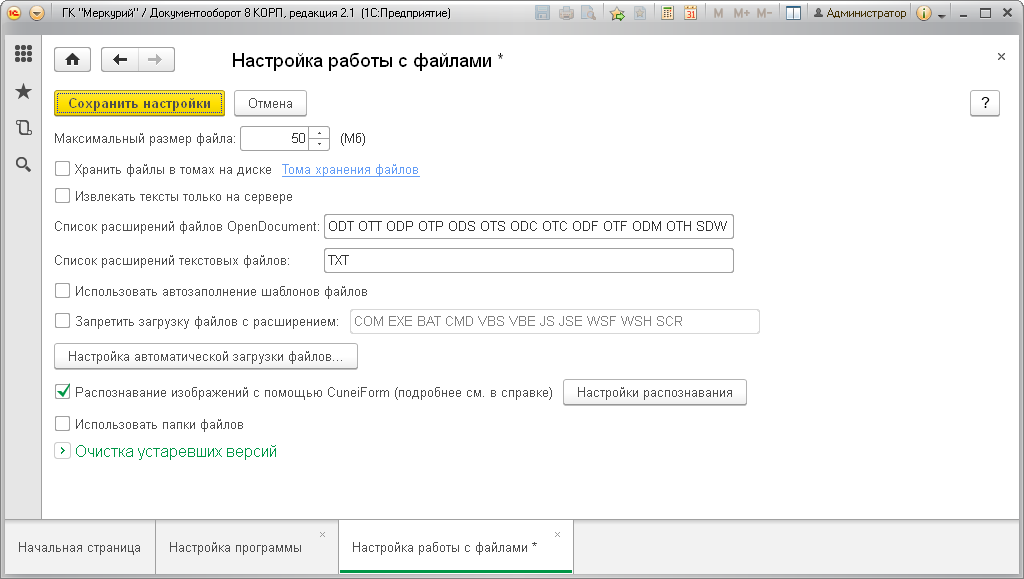
Также должно быть включено распознавание текста: Настройка и администрирование - Настройка программы - Работа с файлами - Распознавание изображений с помощью CuneiForm.
Файлы, полученные со сканера, содержат только графический слой (современные сканеры часто сканируют несколько страниц в pdf-файл). Для извлечения текстов таких файлов в «1С:Документооборот» используется программа ImageMagick, которая преобразует PDF-файл в несколько файлов формата .png. Затем при помощи компоненты CuneiForm из этих файлов извлекается текст.
Текст из файлов формата PDF, которые содержат текстовый слой, может быть извлечен с помощью плагина Adobe iFilter.
ImageMagick, CuneiForm и плагины iFilter необходимо самостоятельно установить на компьютер, на котором будет производиться извлечение текстов.
Если тексты извлекаются на сервере необходимо установить компоненту GhostScript на сервере.
Также должно быть включено распознавание текста: Настройка и администрирование - Настройка программы - Работа с файлами - Распознавание изображений с помощью CuneiForm.
Что проверить, если pdf-файл не находится поиском?
Если не удается найти pdf-файл, надо первым делом проверить, есть ли текст в реквизите «Текстовый образ».◉ Остались вопросы?
Наши эксперты помогут подобрать решение под ваши задачи.